18 oktober 2026
Bij AI-video denken de meeste mensen aan één ding: een prompt uitschrijven en op genereren drukken. Dat levert een leuk filmpje op, maar geen video waar je een merk op bouwt. Zo werken wij dan ook niet. Wij ontwikkelen eerst de personages en omgevingen, en houden die van de eerste tot de laatste scene consistent. In dit artikel lees je hoe dat werkt, wat het oplevert en waar de grenzen liggen.

De meeste mensen denken dat AI-videoproductie draait om de juiste prompt. Je typt wat je wil zien, drukt op genereren en het model doet de rest. Elke maand verschijnt er wel een nieuwe demo die precies dat belooft: fotorealistische video met één klik.
Die demo's laten vooral zien wat er misgaat zonder regie. Een losse generatie ziet er in de eerste seconde indrukwekkend uit, maar in scene twee heeft je hoofdpersoon een ander gezicht, een andere jas of staat hij in een kantoor dat er net anders uitziet. Voor een social post is dat misschien acceptabel. Voor een merkvideo, een campagne of een e-learning van twintig minuten niet.
Het probleem zit dus niet in de kwaliteit van één beeld, maar in de samenhang tussen alle beelden.
Wij maken AI-video's met Higgsfield: een platform dat de grote beeld- en videogeneratoren samenbrengt, aangevuld met AI-tooling om personages, camera en beweging te sturen. Daardoor zitten we niet vast aan één model en de beperkingen daarvan.
Dat is belangrijk, want geen enkel model is goed in alles. Het ene model zet de mooiste sfeer neer, het andere is beter in een herkenbaar gezicht, een leesbare tekst of een exact productdetail. Wij kiezen per taak het model dat erbij past, en combineren ze in één productie.
Maar de tool is niet het verschil. Het verschil zit in wat we ermee bouwen voordat er één eindscene bestaat.
Een AI-video voelt pas echt als je personages en omgevingen de hele video hetzelfde blijven. Daarom ontwikkelen we die eerst, als vaste bouwstenen, en genereren we pas daarna de scenes.
Dat werkt net zo goed voor een video van dertig seconden als voor een complete e-learning met tientallen modules. De cursist ziet in les tien dezelfde trainer in dezelfde ruimte als in les één.
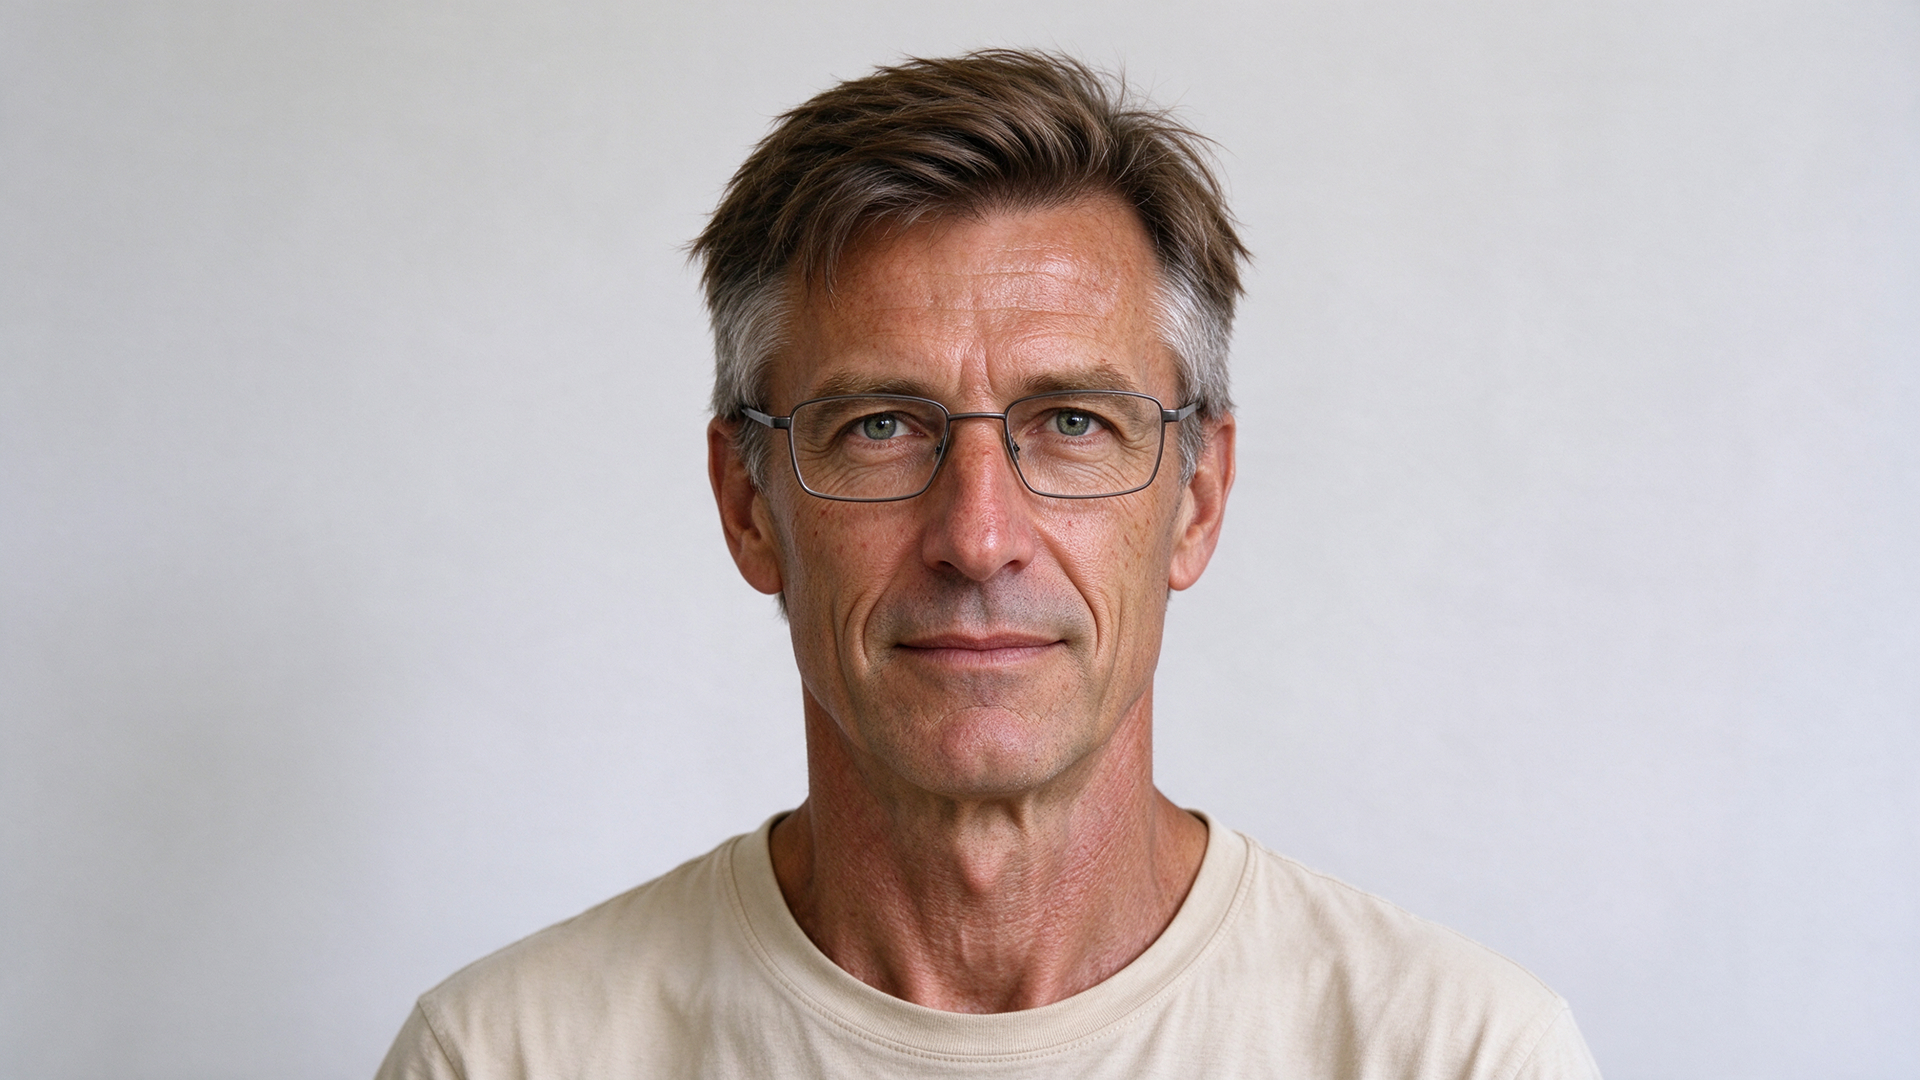
Een personage blijft consistent als elke referentie maar één taak heeft. Laat je één beeld tegelijk het gezicht én de kleding sturen, dan begint het personage na een paar scenes te verschuiven. Dat heet karakterdrift. In de praktijk hanteren we een paar vaste regels:
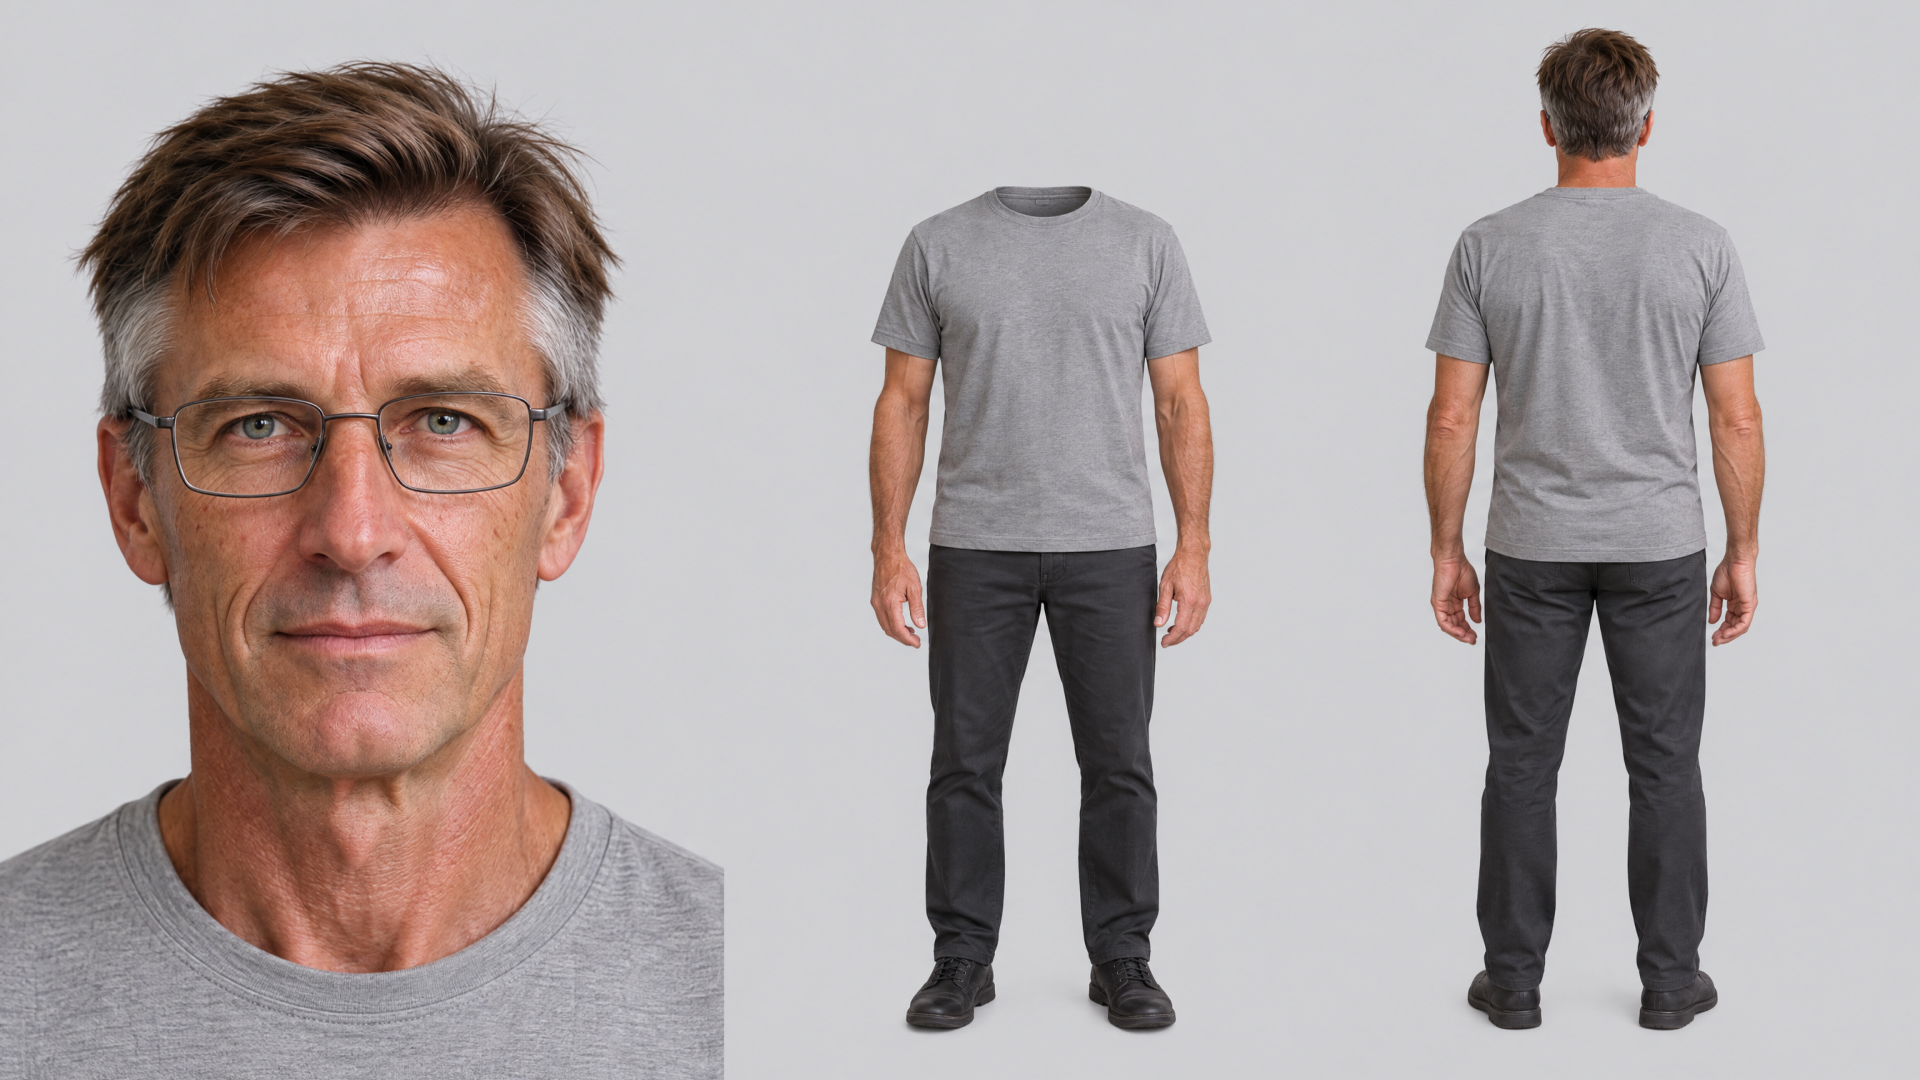
Omdat de personages en omgevingen vastliggen, zijn we niet meer afhankelijk van de grillen van een AI-model. En ook niet van dure shootdagen. Dat geeft vrijheid die je met een camera alleen niet hebt:
Dat maakt AI-video vooral interessant voor merken die veel en vaak content nodig hebben: terugkerende campagnes, meerdere productlijnen binnen dezelfde visuele wereld, of e-learnings die je wil uitbreiden zonder alles opnieuw te filmen.
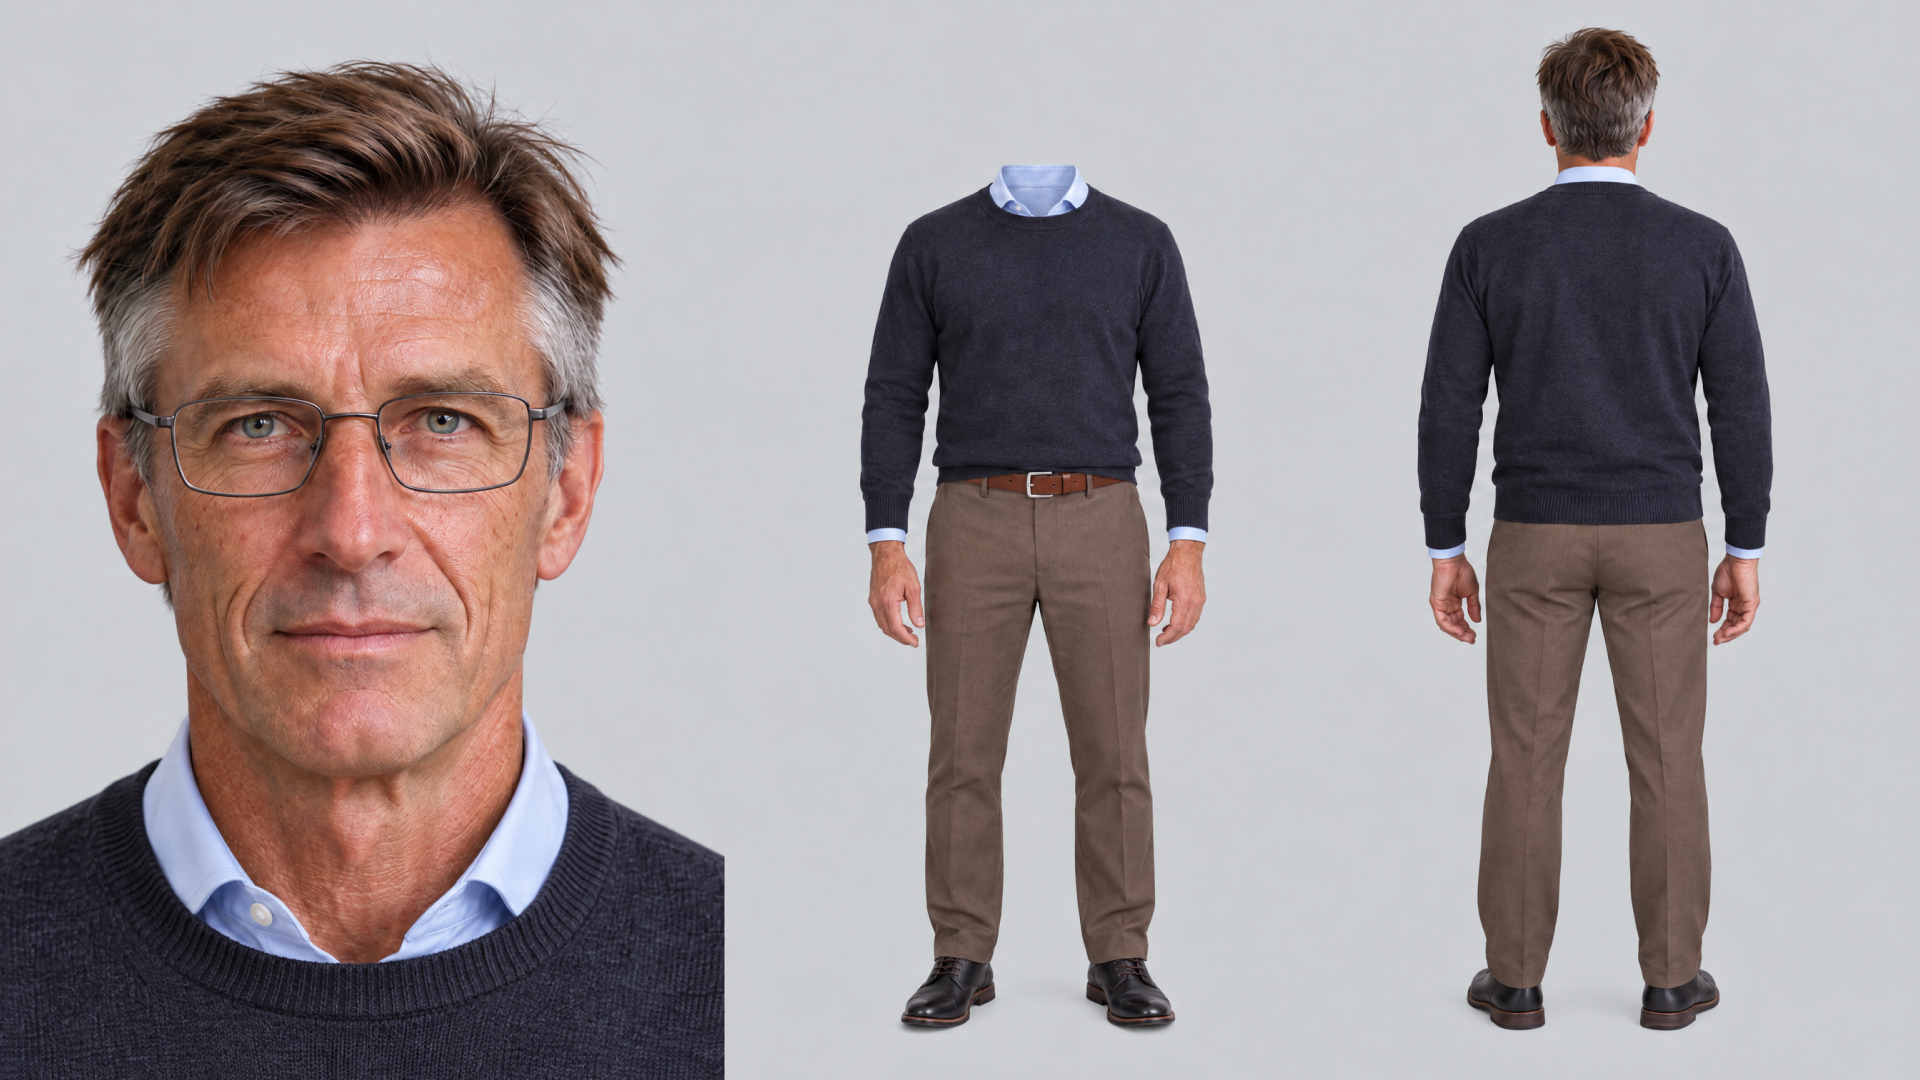
In beide gevallen bepaalde niet de laatste generatie het resultaat, maar de discipline in de opbouw ervoor.
Stap 4: zet je AI-personage in een video of scene
AI-video is niet overal de beste keuze, en dat zeggen we liever vooraf dan achteraf.
AI-video is voor ons dus een uitbreiding van de gereedschapskist, geen vervanging ervan.
AI-videoproductie is geen prompten. Het is personages en omgevingen ontwikkelen die zo consistent zijn dat ze net echt lijken. Daarvoor heb je dezelfde regie nodig als op een set: iemand die weet wat een goede compositie, belichting en verhaallijn is. Alleen werk je met andere gereedschappen.
De modellen worden elke paar maanden beter. Daardoor maakt de techniek steeds minder het verschil, en de creatieve keuzes steeds meer: verhaal, kadrering, timing en merkconsistentie.
Benieuwd wat dit voor jouw merk, campagne of e-learning kan betekenen? Neem contact met ons op, dan laten we je zien hoe we dat aanpakken.