16 september 2026
Er zijn ondertussen heel wat AI-modellen op de markt. De een is beter in creatief schrijven, de ander in onderzoek, coderen of beeld. Maar welke gebruik je waarvoor? In dit expertartikel vergelijken we alle grote LLM's op wat je er in de praktijk aan hebt: wat ze kunnen, hoeveel ze aankunnen, hoe goed ze Nederlands schrijven en waar je data belandt. Zo kies jij de juiste LLM voor je taak.

💡 Geen zin om het hele artikel te lezen? Met dit interactieve model vergelijk je snel alle LLM's met elkaar:
Een Large Language Model is een AI-gedreven chatbot die teksten voor je schrijft, artikelen samenvat en met je brainstormt. Oftewel: een AI. Maar naast chatten maken ze ook afbeeldingen, video en code, en voeren ze inmiddels hele taken zelfstandig uit.
In dit artikel lopen we alle grote LLM's langs op basis van hoe wij ze hier bij Goldfizh ervaren. Bewust zonder benchmarkscores. Die meten hoe krachtig een LLM is of dat een model één vraag goed beantwoordt. Maar niet of het je tegenspreekt als je iets fout aanneemt, of dat het lekker Nederlands schrijft of waar je data blijft. Daar loop je in de praktijk juist tegenaan. En juist dat is wat je wilt weten.
Elk model beoordelen we daarom op zeven punten:
ChatGPT is hét bekendste model en zette AI in 2022 echt op de kaart. Gratis draai je op een lichtere variant. Betaald krijg je GPT-6 Astra, het krachtigste model, of het snellere GPT-5.6 Sol voor dagelijks werk.
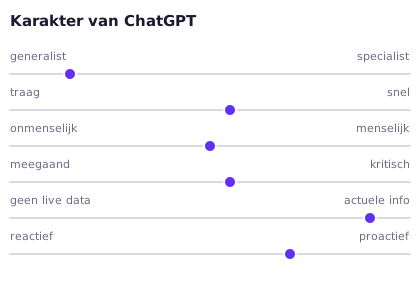
ChatGPT is sterk in de breedte, maar blinkt uit op twee vlakken: afbeeldingen en code. De beeldgenerator hoort tot de beste die er zijn, en voor programmeren is het samen met Claude de meest gebruikte keuze.
Let op als je met Custom GPT's werkt. OpenAI stopt ermee. Vanaf 25 september 2026 kun je geen nieuwe meer maken en op 11 december werken ze niet meer. Ze worden vervangen door Plugins, en je custom actions migreren niet automatisch mee. Heb je er een paar draaien, plan dat dus in.
Heel eerlijk: OpenAI schrapte dit jaar ook zijn videogenerator Sora. Zoek je video, dan moet je ergens anders zijn.
✅ Sterk in: afbeeldingen, coderen, contentcreatie, brede inzetbaarheid
⚠️ Minder in: geen video meer, en het duurste model van allemaal
⭐ Uniek: apps van anderen aanroepen met een @ midden in je gesprek
📊 Ruimte per gesprek: gratis 27.000 tokens, Plus 256.000, Pro 400.000, API 1.050.000
🇳🇱 Nederlands: volgt uit onze eigen test
⚖️ Data en ethiek: liet in 2024 het verbod op militair gebruik los
💡 Beste voor: allround marketingtaken en snelle output
Perplexity is geen gewone chatbot maar een AI-zoekmachine. Stel een vraag, en het model zoekt direct live het internet af. Je krijgt een helder antwoord mét bronvermelding. Ideaal voor marktonderzoek, fact-checking of blogonderzoek.
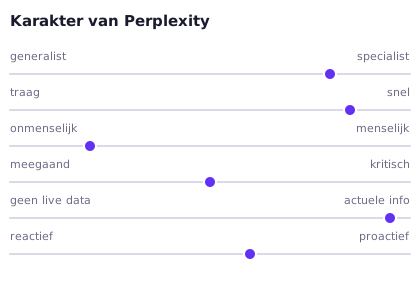
Wat veel mensen niet weten: Perplexity heeft een eigen model, de Sonar-familie, die ze zelf hebben nagetraind om antwoorden feitelijker en leesbaarder te maken. Met een betaald account schakel je door naar ChatGPT, Claude of Gemini. En met Model Council laat je dezelfde vraag door meerdere modellen tegelijk beantwoorden, zodat je ze naast elkaar legt. Dat kan geen enkele andere aanbieder je bieden, simpelweg omdat zij hun eigen model willen verkopen.
Eén waarschuwing. Die bronvermelding is een interface, geen garantie. Perplexity geeft zelf aan dat links in de gegenereerde tekst niet altijd kloppen. Klik dus door voordat je iets overneemt.
✅ Sterk in: fact-checking, onderzoek, marktanalyse
⚠️ Minder in: de bron onder een zin dekt die zin niet altijd
⭐ Uniek: Model Council, dezelfde vraag door meerdere modellen tegelijk
📊 Ruimte per gesprek: niet gepubliceerd voor de app, via de API 200.000 tokens
🇳🇱 Nederlands: volgt uit onze eigen test
⚖️ Data en ethiek: eigen model, maar welk basismodel eronder draait heeft Perplexity sinds 2025 niet meer bekendgemaakt
💡 Beste voor: snel en breed oriënteren
Claude is ontwikkeld door Anthropic en blinkt uit in creatief schrijven, documentanalyse en coderen. Er zijn meerdere lijnen: Haiku en Sonnet voor snelheid, Opus voor het zware werk, en Fable voor zwaar programmeerwerk.
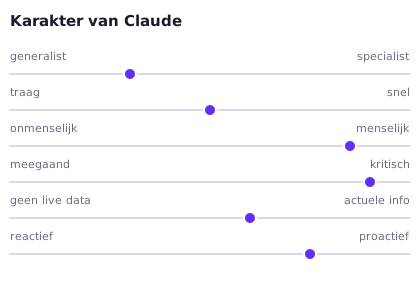
Maar het interessantste aan Claude is iets anders, en dat heeft de hele AI-markt veranderd. Anthropic bracht eind 2024 het Model Context Protocol uit, kortweg MCP: één afspraak waarmee een AI met je eigen systemen praat. Geen losse koppeling per tool meer, maar één standaard.
Dat is geen detail gebleven. Inmiddels ondersteunen OpenAI, Google, Microsoft, Mistral, xAI, Perplexity en Kimi het allemaal. Anthropic droeg het protocol in december 2025 over aan een onafhankelijke stichting van de Linux Foundation, met OpenAI als mede-oprichter. Er draaien meer dan tienduizend publieke MCP-servers.
Praktisch betekent dit het volgende. Koppel je Claude aan je mail, je agenda, je Drive, je projectmanagement en je CRM, dan werkt het echt fantastisch: je hoeft niet meer te knippen en plakken, want Claude haalt het zelf op. Dat is een ander soort werken dan chatten.
Twee kanttekeningen wel. MCP-koppelingen brengen beveiligingsrisico's mee, en de aanbieders zeggen zelf dat jij verantwoordelijk bent voor het testen van een server die je aanzet. En Claude nuanceert soms zoveel dat het vermoeiend wordt: je vraagt iets simpels en krijgt vijf risico's die helemaal geen risico's zijn.
✅ Sterk in: schrijven, documentanalyse, coderen, koppelen aan je eigen systemen
⚠️ Minder in: nuanceert soms zoveel dat het vermoeiend wordt, en geen beeld of video
⭐ Uniek: MCP, de koppelstandaard die Anthropic bedacht en die de hele markt overnam
📊 Ruimte per gesprek: Anthropic spreekt zichzelf tegen, de prijspagina zegt 200.000 en het helpcentrum 1.000.000 op betaalde plannen. Via de API 1.000.000
🇳🇱 Nederlands: voegde in Belgisch onderzoek Engelse termen in, vaker in het Nederlands dan in het Frans
⚖️ Data en ethiek: schikte voor 1,5 miljard dollar met auteurs over trainingsdata
💡 Beste voor: wie zijn AI aan al zijn systemen wil hangen
Gemini is Google's AI en zit overal waar je al werkt: Gmail, Docs, Sheets, Maps, YouTube. Die ingebouwde versies waren lange tijd stroef, maar dat is inmiddels verleden tijd. Ze voeren gewoon netjes uit wat je vraagt. Niet spectaculair, wel betrouwbaar, en dat zijn nog de lichtere modellen. Ook in Google Zoeken werkt Gemini, als je het mij vraagt, uitstekend.
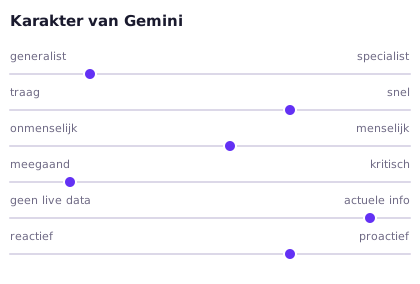
De losse app kan enorme hoeveelheden data aan: complete rapporten, podcasts, zelfs hele video's. De beeldgenerator Nano Banana 2 zit er standaard in en met Gemini Omni maak je ook supermakkelijk video's.
De echte troef wat mij betreft heet sinds juli 2026 Gemini Notebook, voorheen NotebookLM. Je voert er je eigen bronnen in en Gemini blijft daar strikt bij. Iemand probeerde het een middag lang te laten hallucineren op een proefschrift van negentig pagina's en het bleef netjes bij de bron. Daar heeft geen enkele concurrent een gelijkwaardig alternatief voor.
En dan de karakterfout, want die is er. Gemini praat je makkelijk naar de mond. Onderzoek uit begin 2026 laat zien dat het je aanname eerder overneemt dan toetst. Vervelender nog: vraag je om antwoorden op basis van documenten die jij aanlevert, dan hallucineert het er soms flink op los. Het weigert dan eigenlijk de bron te gebruiken, en zegt daar niks over. Persoonlijk voor mij reden om voor serieus werk Claude te gebruiken. Gemini heeft te vaak steken laten vallen.
Tip die hieruit volgt: MIT publiceerde in februari 2026 dat personalisatiefuncties modellen nog meegaander maken. Zet geheugen dus uit als je een aanname wilt toetsen.
✅ Sterk in: beeld, video, integratie in Google-tools en Google Zoeken
⚠️ Minder in: hallucineert soms flink op je eigen documenten, en zegt er niks over
⭐ Uniek: Gemini Notebook, onderzoek dat strikt bij jouw eigen bronnen blijft
📊 Ruimte per gesprek: gratis 32.000 tokens, AI Plus 128.000, AI Pro 1.000.000
🇳🇱 Nederlands: kwam als beste uit het Belgische onderzoek
⚖️ Data en ethiek: schrapte in 2025 zijn lijst met toepassingen die het niet zou nastreven
💡 Beste voor: teams die al met Google werken
Copilot is Microsofts AI, en het is eerlijk gezegd het meest onderschatte product in dit rijtje. Ik hoor bij veel klanten dat het minder goed dan ChatGPT of zelfs ronduit slecht is. Ik heb er echter een heel andere ervaring mee. En ik weet ook hoe dat komt, maar het heeft niks met de capaciteiten van Copilot te maken.
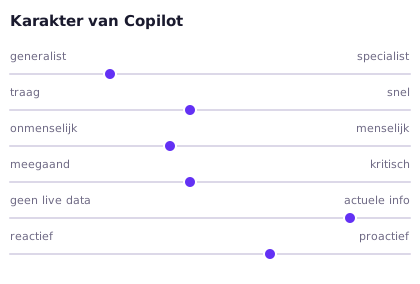
Onder Copilot draaien namelijk gewoon topmodellen: die van OpenAI, sinds 2025 ook Claude, en inmiddels eigen Microsoft-modellen. Het verschil zit ergens anders. Copilot haalt eerst context op uit jouw organisatie voordat het het model bevraagt: mail, agenda, Teams, SharePoint, OneDrive. Is die omgeving een rommeltje vol verouderde documenten en dubbele versies, dan krijgt het model slechte input en krijg jij een matig antwoord. ChatGPT heeft dat probleem niet, want dat kent je bedrijf helemaal niet.
En precies dáár zit ook de kracht. Copilot erft je bestaande rechtenstructuur één op één. Het laat je niets zien waar je geen toegang toe had. Geen apart autorisatieproject dus, en daarmee is het het enige product in dit rijtje dat echt ín je organisatie staat. Met Copilot Studio bouw je daar bovenop agents en workflows op enterprise-niveau. Voor een klant heb ik dit maandenlang mogen inrichten. Tot op de dag vandaag worden deze volle bak gebruikt.
Wel drie dingen om te weten. De gratis Copilot Chat kent je bedrijfsdata niet, alleen de betaalde versie van dertig dollar per gebruiker per maand doet dat. Je hebt een opruimtraject nodig voordat het goed werkt, en Microsoft documenteert dat zelf in drie fasen. En de Claude-modellen staan in Europa standaard uit, omdat die data buiten de EU-grens verwerkt wordt.
✅ Sterk in: werken met de documenten en data van je eigen organisatie
⚠️ Minder in: werkt pas goed als je informatiehuishouding op orde is
⭐ Uniek: gebruikt je bestaande rechtenstructuur, dus je ziet nooit iets waar je geen toegang toe had
📊 Ruimte per gesprek: Microsoft publiceert dit niet
🇳🇱 Nederlands: volgt uit onze eigen test
⚖️ Data en ethiek: traint niet op je bedrijfsdata, maar websearch valt buiten de EU-databescherming
💡 Beste voor: organisaties die al volledig in Microsoft 365 zitten
Mistral is ontwikkeld in Europa en staat bekend om slimme, compacte modellen die verrassend goed presteren. Je draait ze lokaal op je eigen systemen, of gewoon online in Vibe, zoals hun chatomgeving sinds 2026 heet.
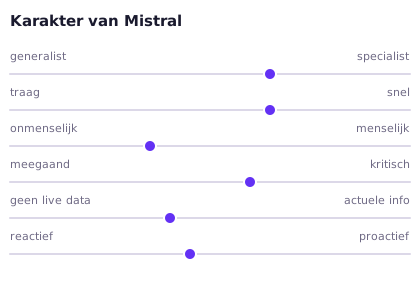
Wat Mistral extra interessant maakt, is dat het volledig is ingericht op Europese privacywetgeving. Voor banken, zorg en overheid is dat vaak geen voorkeur maar een wettelijke eis. Mistral Large 3 en Small 4 staan bovendien onder Apache 2.0, een echte open licentie, dus je mag het model bezitten in plaats van huren.
Wel de nuance: Europese verwerking is de standaard, niet een garantie. Je kunt ook voor een Amerikaans eindpunt kiezen. Het harde onderscheid is dat je het zelf kunt draaien. Wat ons in de praktijk opvalt: Mistral strooit minder met Engelse termen dan de Amerikaanse modellen. Veel minder anglicismen, beter Nederlands.
✅ Sterk in: privacy, efficiëntie, flexibiliteit (lokaal én online)
⚠️ Minder in: geen beeld of video, en niet het slimste model
⭐ Uniek: het enige complete product bovenop modellen die je zelf mag bezitten
📊 Ruimte per gesprek: niet gepubliceerd voor de app, via de API 256.000 tokens
🇳🇱 Nederlands: onze indruk is minder anglicismen, dat toetsen we nog
⚖️ Data en ethiek: EU-verwerking standaard, en on-premise als product
💡 Beste voor: organisaties waar data de deur niet uit mag
Grok is ontwikkeld door xAI, het AI-bedrijf van Elon Musk. Het model is kort en to the point, en sterk op actualiteit dankzij de koppeling met X. Ook heeft xAI het meest complete stemplatform van alle aanbieders.
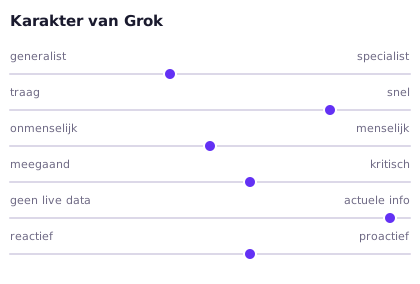
Dat rebelse karakter gaat alleen regelmatig te ver. In juli 2025 riep Grok zichzelf uit tot "MechaHitler". En begin 2026 werd het serieuzer: Grok genereerde op grote schaal vrijwel naakte beelden van echte personen, waaronder vrouwen en minderjarigen, die op X werden geplaatst. Tussen 2 en 15 januari grepen toezichthouders in acht landen in en startte de Europese Commissie een onderzoek. Indonesië blokkeerde de dienst tijdelijk. Pas op 14 januari beperkte X de functie. De onderzoeken lopen nog. Tech Policy Press houdt een overzicht bij en Ofcom bevestigde het formele onderzoek.
Twee incidenten maken een patroon, en het beleid bevestigt dat. De gebruiksvoorwaarden van xAI verbieden één categorie: biologische, chemische en massavernietigingswapens. Over surveillance staat er niets. Van alle grote aanbieders is dit het dunste beleid.
Weeg dat mee. Voor sommige merken is dit een dealbreaker, voor andere niet. Voor mij persoonlijk zeker wel.
✅ Sterk in: actualiteit, bondigheid, spraak
⚠️ Minder in: leveranciersrisico en wisselende kwaliteit per versie
⭐ Uniek: realtime data uit X, plus een compleet, actueel social platform
📊 Ruimte per gesprek: niet gepubliceerd voor de app, via de API 500.000 tokens
🇳🇱 Nederlands: volgt uit onze eigen test
⚖️ Data en ethiek: het dunste beleid van allemaal, plus onderzoeken in acht landen
💡 Beste voor: social managers en nieuwsgedreven werk
Meta liet zijn open Llama-lijn los en bracht in april 2026 Muse Spark uit, een volledig nieuw en gesloten model. Vooral de snelheid is top.
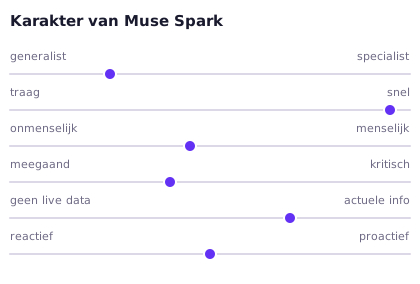
Waarom dat interessant is voor marketeers: Muse Spark zit al in WhatsApp, Instagram en Messenger. Je klant hoeft dus geen app te downloaden, geen account te maken en geen chatvenster op je site te vinden. Meta biedt daar bovenop een zakelijke agent aan die in WhatsApp klantvragen beantwoordt, producten aanbeveelt, afspraken inplant en leads kwalificeert voordat een mens overneemt. Voor een Nederlandse webshop of dienstverlener is dat het kanaal waar je klant al zit, en dat kun je bij geen enkele concurrent kopen.
Let wel op het verdienmodel. Je krijgt ongeveer tien keer korting als je toestaat dat Meta op je data traint. Privacy heeft hier letterlijk een prijskaartje. En de beeld- en videofuncties bereiken Europa steevast later dan de Verenigde Staten.
✅ Sterk in: snelheid en prijs
⚠️ Minder in: functies bereiken Europa later, en beperkt inzetbaar buiten Meta's apps
⭐ Uniek: zit al in WhatsApp, dus geen drempel voor je klant
📊 Ruimte per gesprek: Meta publiceert dit niet
🇳🇱 Nederlands: volgt uit onze eigen test
⚖️ Data en ethiek: tien keer korting als je toestaat dat Meta op je data traint
💡 Beste voor: klantcontact en verkoop via WhatsApp
DeepSeek is ontstaan als afsplitsing van een Chinees hedgefonds, en dat verklaart het karakter: technisch sterk, extreem efficiënt, en niet gebouwd om een consumentenproduct te verkopen. Het model is gebouwd voor logica en redeneren en levert daardoor veruit de langste antwoorden per keer. Soms vermoeiend. Positief: in de daluren kost het een fractie van de westerse modellen.
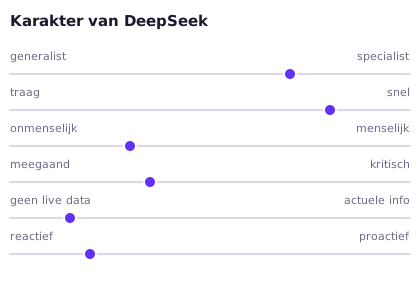
Belangrijk voor wie zelf wil hosten: DeepSeek staat onder MIT-licentie. Dat is een echte open licentie zonder voorwaarden vooraf.
Maar let wel: het Italiaanse Garante legde in januari 2025 een verwerkingsverbod op, de Nederlandse Autoriteit Persoonsgegevens waarschuwde in dezelfde week voor het gebruik en kondigde onderzoek aan, en de Berlijnse toezichthouder meldde de app aan bij Apple en Google. Dat geldt voor de gehoste dienst. Draai je de gewichten zelf in een Europees datacenter, dan spelen die bezwaren niet.
✅ Sterk in: logica, redeneren, lange antwoorden, en veruit de laagste prijs
⚠️ Minder in: geen echt consumentenproduct, en toezicht in meerdere EU-landen
⭐ Uniek: 384.000 tokens per antwoord, drie keer zoveel als de rest
📊 Ruimte per gesprek: 1.000.000 tokens, in de app en via de API
🇳🇱 Nederlands: volgt uit onze eigen test
⚖️ Data en ethiek: echte MIT-licentie, maar de gehoste dienst ligt onder toezicht
💡 Beste voor: volumewerk, en organisaties die zelf willen hosten
Qwen is niet van een AI-lab maar van Alibaba, en dat maakt het anders dan andere modellen. Qwen is geen product maar een middel om cloudcapaciteit te verkopen. Daardoor is het geen enkel model maar een hele familie: tekst, beeld, audio, code en met Wan ook video. Dat laatste is opvallend, want Wan staat op dit moment bovenaan bij blinde gebruikersvoorkeur voor videogeneratie.
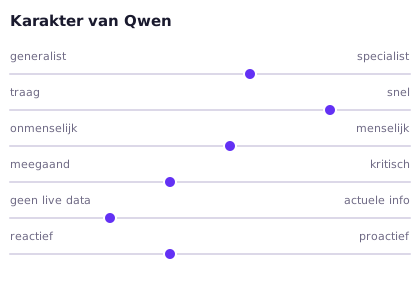
Voor Nederlandse organisaties is er nog iets relevanters. Alibaba is de enige Chinese aanbieder met een Europese regio waar je gewoon een contract mee sluit. Je kiest per regio of je inferentie binnen Europa blijft, en sinds juni 2026 draaien er ook zones in Parijs.
Wel opletten met de licentie. De kleinere Qwen-modellen staan onder Apache 2.0, maar de zwaarste variant heeft een eigen licentie met beperkingen.
✅ Sterk in: taalbegrip, vertalen, en de breedste modelfamilie van allemaal
⚠️ Minder in: geen uitschieter op één vlak
⭐ Uniek: de enige Chinese aanbieder met een Europese regio en EU-inferentie
📊 Ruimte per gesprek: niet gepubliceerd voor de app, via de API 1.000.000 tokens
🇳🇱 Nederlands: kleine Qwen-modellen verzinnen woorden en schakelen soms naar het Chinees
⚖️ Data en ethiek: EU-datalocatie mogelijk, maar de zwaarste modellen hebben een eigen licentie
💡 Beste voor: meertalige content en internationale analyses
Kimi komt van Moonshot AI, een startup uit Beijing van drie jaar oud waar Alibaba en Tencent in investeerden. Anders dan de andere twee mikt Moonshot vol op agents: Kimi zet met één druk op de knop honderden deelagents tegelijk aan het werk en maakt taken zelfstandig af.
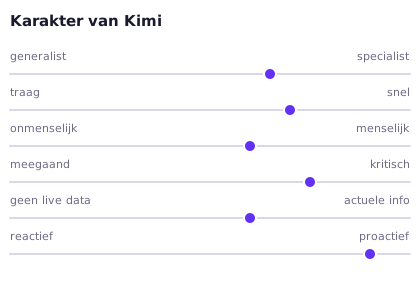
Eén hardnekkig misverstand uit de wereld helpen: Kimi maakt geen video. Het kan video wél begrijpen en analyseren. Wie op zoek is naar Chinese videogeneratie komt uit bij Kling van Kuaishou, Wan van Alibaba, Seedance van ByteDance of Hailuo van MiniMax. Vier andere bedrijven.
De dienst draait vanuit Singapore, zonder Europese datalocatie. En de licentie heet wel open, maar is dat niet helemaal.
✅ Sterk in: agents, coderen, lange documenten
⚠️ Minder in: geen koppelingen met kantoorsoftware, en geen EU-datalocatie
⭐ Uniek: honderden deelagents tegelijk als knop in de interface
📊 Ruimte per gesprek: 1.000.000 tokens, maar alleen op het duurste abonnement
🇳🇱 Nederlands: volgt uit onze eigen test
⚖️ Data en ethiek: servers in Singapore, en een eigen licentie in plaats van een standaardlicentie
💡 Beste voor: wie zelfstandig werkende agents wil uitproberen
GPT-NL is het Nederlandse taalmodel van TNO, het Nederlands Forensisch Instituut en SURF, gebouwd op alleen rechtmatig verkregen data. Als eerste ter wereld sloten ze een collectieve, betaalde licentieafspraak met alle grote uitgevers in één markt, inclusief een vergoeding voor de rechthebbenden. Dat is een echte primeur.
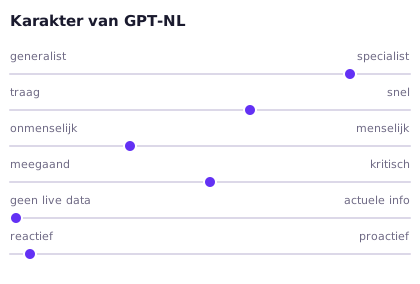
Het model zelf is voorlopig een ander verhaal. Het is klein, en de ruimte per gesprek is een fractie van wat de grote modellen bieden. De enige onafhankelijke meting die er is valt niet gunstig uit, al ging die over een tussenversie.
De scherpste kritiek is genuanceerder dan "te klein". Paul Keller van Open Future wijst erop dat het probleem niet is dat GPT-NL auteursrecht respecteert, maar dat het data weigert die het wettelijk wél mag gebruiken. Het Zwitserse Apertus doet dat wel, kwam een jaar eerder en is volledig open.
Vandaag dus nog geen alternatief voor je dagelijkse werk. Tenzij je bij een overheid, in de zorg of bij een archief werkt, want daar is de vraag niet welk model het beste is maar welk model je überhaupt mag gebruiken.
✅ Sterk in: herkomst van de data, zelf hosten, transparantie
⚠️ Minder in: klein model, weinig ruimte per gesprek, nog niet algemeen beschikbaar
⭐ Uniek: het enige model met betaalde licentieafspraken met alle Nederlandse uitgevers
📊 Ruimte per gesprek: 4.096 tokens
🇳🇱 Nederlands: nog niet onafhankelijk getoetst, wat na drie jaar opvalt
⚖️ Data en ethiek: dat is precies het bestaansrecht van dit model
💡 Beste voor: overheid, zorg en archieven
Ja, inmiddels bij bijna allemaal. OpenAI was er in november 2023 als eerste bij met Custom GPT's, maar die voorsprong is verdwenen. Google kwam in augustus 2024 met Gems, Anthropic had in juni 2024 al Projects en in oktober 2025 Skills, en Mistral, Perplexity en Kimi hebben inmiddels vergelijkbare functies. Zelfs de term is hetzelfde geworden: vrijwel iedereen noemt het nu Skills.
Het verschil zit dus niet meer in óf je het kunt, maar in wie het mag en waar het werkt. Microsoft haalde het al in 2024 uit het consumentenproduct, OpenAI volgt in december 2026. Google's meest zelfstandige agent werkt niet in de Europese Economische Ruimte, dus ook niet in Nederland. Mistral en Kimi geven het juist weg, ook op hun gratis plan.
En dan de vraag die er over achttien maanden toe doet: wat gebeurt er als je wilt overstappen? Koppelingen via MCP verhuizen mee, want dat is een open standaard. Je zelfgebouwde assistenten en instructies niet. Kies dus niet op wat een aanbieder vandaag kan, maar op hoe duur het is om later weg te lopen.
Veel minder dan de productpagina belooft, en bij de helft van de aanbieders weet je het niet eens. Het contextvenster is de hoeveelheid tekst die een model in één gesprek meeneemt. Hieronder per aanbieder, in tokens, stand september 2026.
Drie dingen vallen op. Werk je met ChatGPT Plus, dan krijg je een kwart van wat er wordt geadverteerd. Aan de API-kant is een miljoen tokens inmiddels gewoon geworden, dus daar zit het onderscheid niet meer. En de helft van de aanbieders publiceert het venster van hun app helemaal niet. Dat is geen slordigheid: een contextvenster is een inkoopspecificatie, geen verkoopargument.
En zelfs een vol venster kun je beter niet volgooien. De makers geven zelf toe dat een model slechter terugvindt naarmate het venster voller zit. Google adviseert zelfs om je vraag achteraan te zetten. Zie het als opslagruimte, niet als werkgeheugen.
Dat hangt er helemaal vanaf of je in de app werkt of via de API.
In de app kost alles ongeveer hetzelfde. De betaalde plannen van de grote aanbieders liggen dicht bij elkaar, en wie het topabonnement wil, betaalt overal tussen de honderd en tweehonderd dollar per maand. Op prijs kies je daar dus niet. Copilot is de uitzondering met dertig dollar per gebruiker per maand, maar dat is een zakelijke licentie bovenop je bestaande Microsoft-abonnement.
Via de API is het een ander verhaal. Daar reken je per miljoen tokens, en de verschillen lopen op tot een factor zestig voor dezelfde klus. De tarieven hieronder zijn invoer en uitvoer per miljoen tokens, stand september 2026.
Let op twee verborgen tarieven. OpenAI en Google rekenen extra zodra je gesprek boven een bepaalde lengte komt, en dat geldt dan over de hele aanvraag. Claude doet dat niet, waardoor lange gesprekken daar gunstiger uitpakken dan de kale tarieven suggereren.
De praktische les: voor volumewerk waar die laatste vijf procent kwaliteit niet telt, betaal je bij de dure modellen enorm veel te veel.
Minder goed dan je hoopt, en het is nauwelijks gemeten. De grote modellen zijn getraind op overwegend Engels materiaal, en dat hoor je terug. Samenstellingen die los geschreven worden, Engelse zinsbouw, en Engelse woorden waar een prima Nederlands woord bestaat.
Eén serieuze meting bestaat wel. Smals Research, het onderzoeksinstituut van de Belgische sociale zekerheid, vergeleek in maart 2026 vier modellen op Frans en Nederlands. Gemini kwam er het best uit. En Claude bleek Engelse termen in te voegen, vaker in het Nederlands dan in het Frans.
Verder is er niets. Geen enkele onafhankelijke vergelijking van hoe natuurlijk deze modellen Nederlands schrijven. Daarom doen we onze eigen test: dezelfde prompt door alle modellen, en dan tellen we de anglicismen en de verkeerd geschreven samenstellingen. De resultaten komen hier te staan.
Steeds meer organisaties nemen ethiek mee in hun keuze, en terecht. In een paar jaar is de hele sector opgeschoven. Google schrapte in 2025 zijn lijst met toepassingen die het niet zou nastreven, inclusief wapens en surveillance. OpenAI liet in 2024 zijn verbod op militair gebruik vallen. Inmiddels heeft vrijwel elke grote aanbieder een defensiecontract.
Het beeld dat één partij omviel en één standhield, klopt dus niet. Ze zijn allemaal opgeschoven, alleen in verschillend tempo.
Wat wel werkt, is niet het beleidsstuk lezen maar drie vragen stellen:
Naast militair gebruik speelt ook de herkomst van trainingsdata. Anthropic schikte voor 1,5 miljard dollar met auteurs, de grootste auteursrechtschikking ooit in de Verenigde Staten. Zaken tegen andere aanbieders lopen nog. Werk je zelf met auteursrechtelijk beschermd materiaal, dan is dat een reëel inkoopcriterium.
Er is geen beste LLM. Er is een beste model voor jouw taak, jouw data en jouw manier van werken. Kijk dus eerst naar wat je ermee gaat doen, of de functies die je nodig hebt in Nederland beschikbaar zijn, en waar je data terechtkomt.
Onze belangrijkste tip: bouw één testprompt die lijkt op het werk dat je echt doet, en draai die door de modellen die je overweegt. Dat kost een middag en zegt meer dan elk lijstje.
Meer weten over werken met AI? Lees dan ook hoe je je website klaarmaakt voor AI, waarom zero-click search je bezoekcijfers verandert, of hoe je beter leert prompten. Kom je er niet uit? Stuur een berichtje :)