8 november 2026
AI-bots lezen je website voordat een klant dat doet. Ze verzamelen trainingsdata, halen live antwoorden op en surfen steeds vaker namens iemand die een product of leverancier zoekt. Tegelijk sluiten platformen hun deuren voor deze bots, omdat data geld waard is geworden. Daarmee wordt toegang een keuze die elk merk moet maken: wat zet je open, wat scherm je af, en wat kost dat? In dit artikel lees je hoe AI-bots werken, waarom ze geblokkeerd worden en hoe jij een goede keuze maakt.

Wil je eerst snappen hoe AI de route naar je merk verandert? Lees dan over de agentreis. En wil je weten hoe je je website klaarmaakt voor AI als gebruiker? Lees dan over agent experience (AX).
Op deze pagina:
AI-bots zijn de programma’s waarmee AI-bedrijven het internet lezen. Ze bezoeken websites, halen de tekst en data op en gebruiken die om taalmodellen te trainen of om vragen van gebruikers te beantwoorden. Ze werken net als de crawlers van zoekmachines, maar met een ander doel: niet een lijst met links tonen, maar zelf een antwoord geven.
Let op: met AI-bots bedoelen we hier niet de chatbots waarmee jij praat, zoals ChatGPT of Gemini. Het gaat om de bots achter die diensten, die jouw website bezoeken om daar informatie op te halen.
Er zijn drie soorten AI-bots, en elk heeft een ander doel. Dat onderscheid is belangrijk, want je kunt per soort kiezen of je ze toelaat.
AI-bots bepalen steeds vaker of je merk in beeld komt. Een klant die een AI-assistent vraagt om de beste leverancier, krijgt een antwoord dat gebaseerd is op wat bots hebben gelezen. Staat jouw informatie daar niet tussen, dan kom je niet eens op het lijstje.
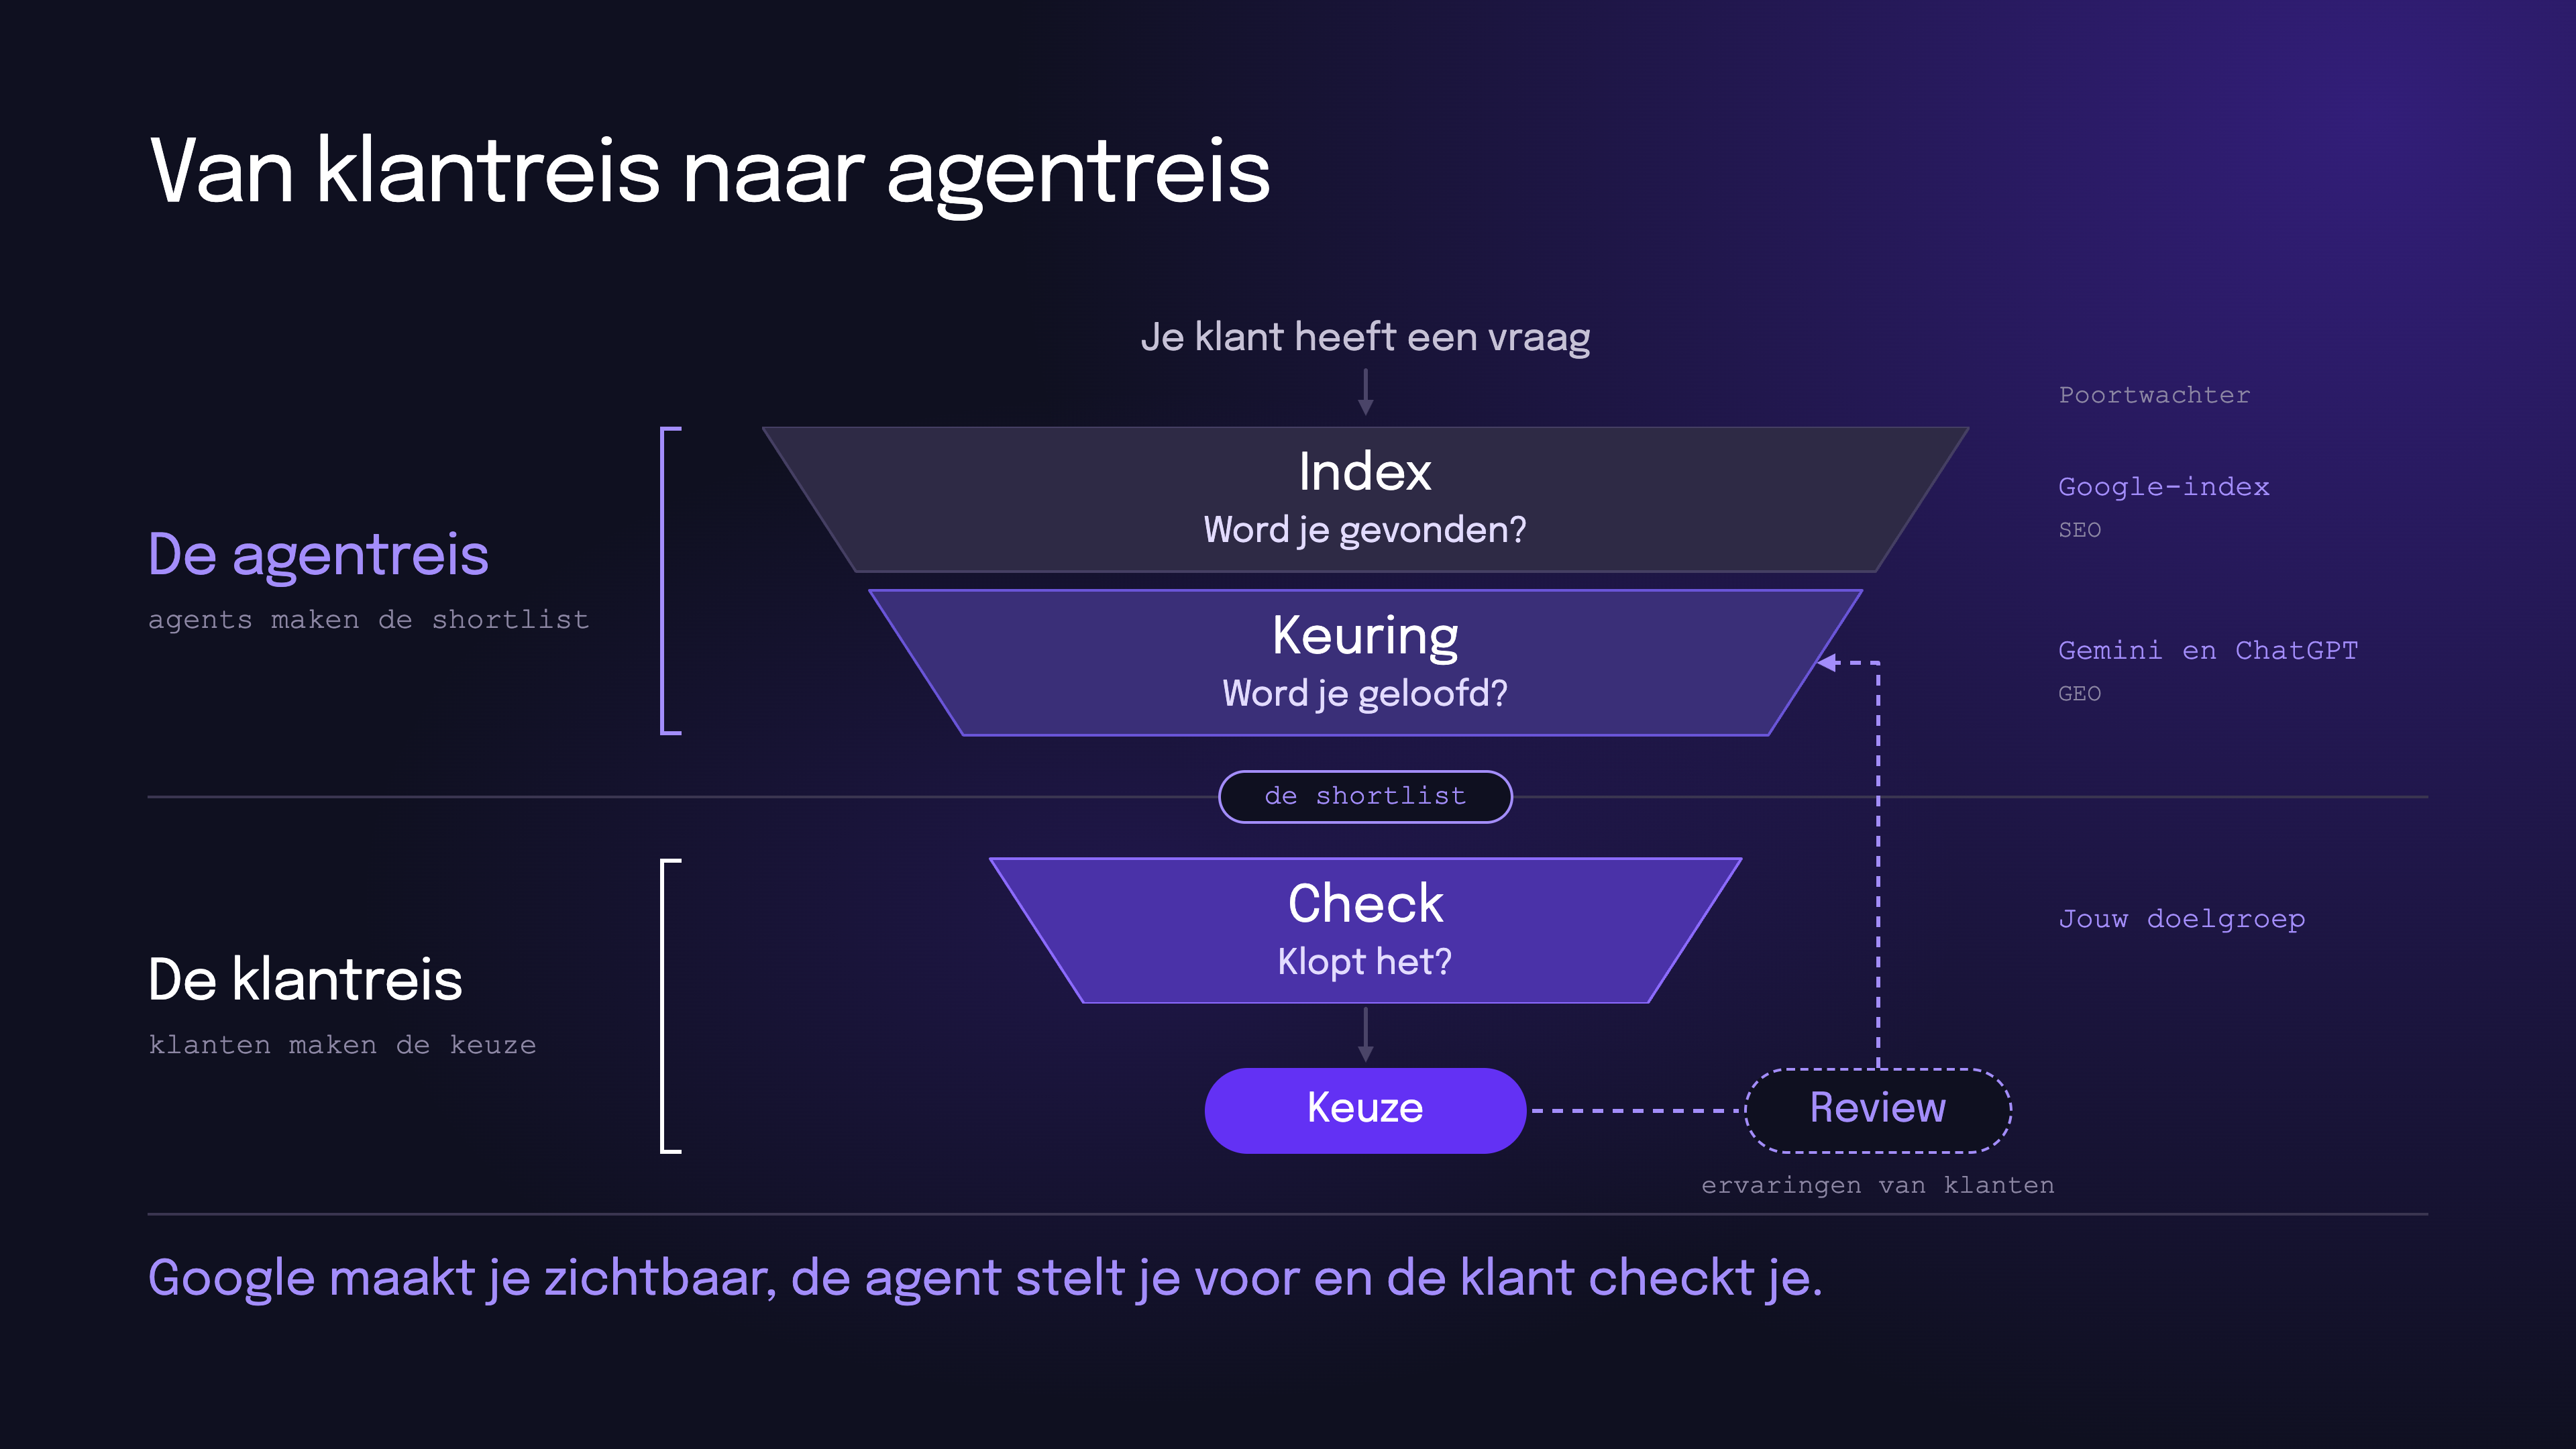
Dat verandert de klantreis. Vroeger zocht een mens zelf, vergeleek hij zelf en klikte hij zelf door. Nu leest de machine eerst en kiest de mens daarna uit wat de machine voorlegt. Die verschuiving noemen wij de agentreis. Wie de AI-bots niet bereikt, mist de eerste selectie.
AI-bots worden geblokkeerd omdat data geld waard is geworden. Wie veel waardevolle content heeft, wil die niet gratis weggeven aan bedrijven die er hun eigen producten mee bouwen. Dus zetten platformen hun data achter een muur, en verkopen ze toegang aan wie betaalt.
Een paar voorbeelden uit 2026 laten zien hoe dat werkt. Google geeft meettools die zijn zoekresultaten uitlezen sinds september een deel van de tijd verkeerde resultaten, en maakt het voor scrapers trager en duurder om links te volgen. Tegelijk betaalt Google Reddit naar verluidt om de content van dat platform te mogen gebruiken. Reddit zelf gaat over naar een grotendeels ingelogde ervaring, om zijn data te beschermen tegen AI-scraping en die in plaats daarvan te verkopen.
De les: lezen is geen principekwestie meer, maar een prijskwestie. Wie de data heeft, bepaalt wie er mag lezen, en tegen welke prijs.
Over AI-bots botsen twee belangen: bescherming van content en zichtbaarheid van merken. Beide kanten hebben een punt, en bijna niemand heeft schone handen.
Critici wijzen erop dat de huidige taalmodellen bestaan bij de gratie van jarenlang ongevraagd lezen, waarvan rechters op veel plekken nog uitzoeken of het mocht. Voor makers, journalisten, kunstenaars en programmeurs is dat zuur: hun werk voedt een product waar zij niets aan verdienen. Columnist Sander Schimmelpenninck schreef in de Volkskrant dat uitgevers daardoor “moeten kiezen tussen twee kwaden”: hun content laten gebruiken en hopen op een enkele doorklik, of weigeren en onzichtbaar worden. Zijn kernpunt is de marktmacht van één partij: zonder echte concurrentie zit iedereen vast aan de keuzes van één poortwachter.
Daar staat de dubbele moraal van de grote platformen tegenover. Google werd groot door het hele web te lezen, maar weert nu anderen die Google lezen. AI-bedrijven bieden een uitknop voor training aan, nadat de modellen al getraind zijn. En merken willen tegelijk beschermd en gevonden worden.
Wij kiezen voor realisme. Het internet wordt gelezen door AI-bots, of je dat nu eerlijk vindt of niet. Ons werk is merken zichtbaar maken op het internet zoals het nu is, en dat betekent bewust kiezen wat je openzet.
Elke soort AI-bot vraagt een eigen afweging, want openzetten levert per soort iets anders op en kost iets anders. Zo zien de voor- en nadelen eruit.
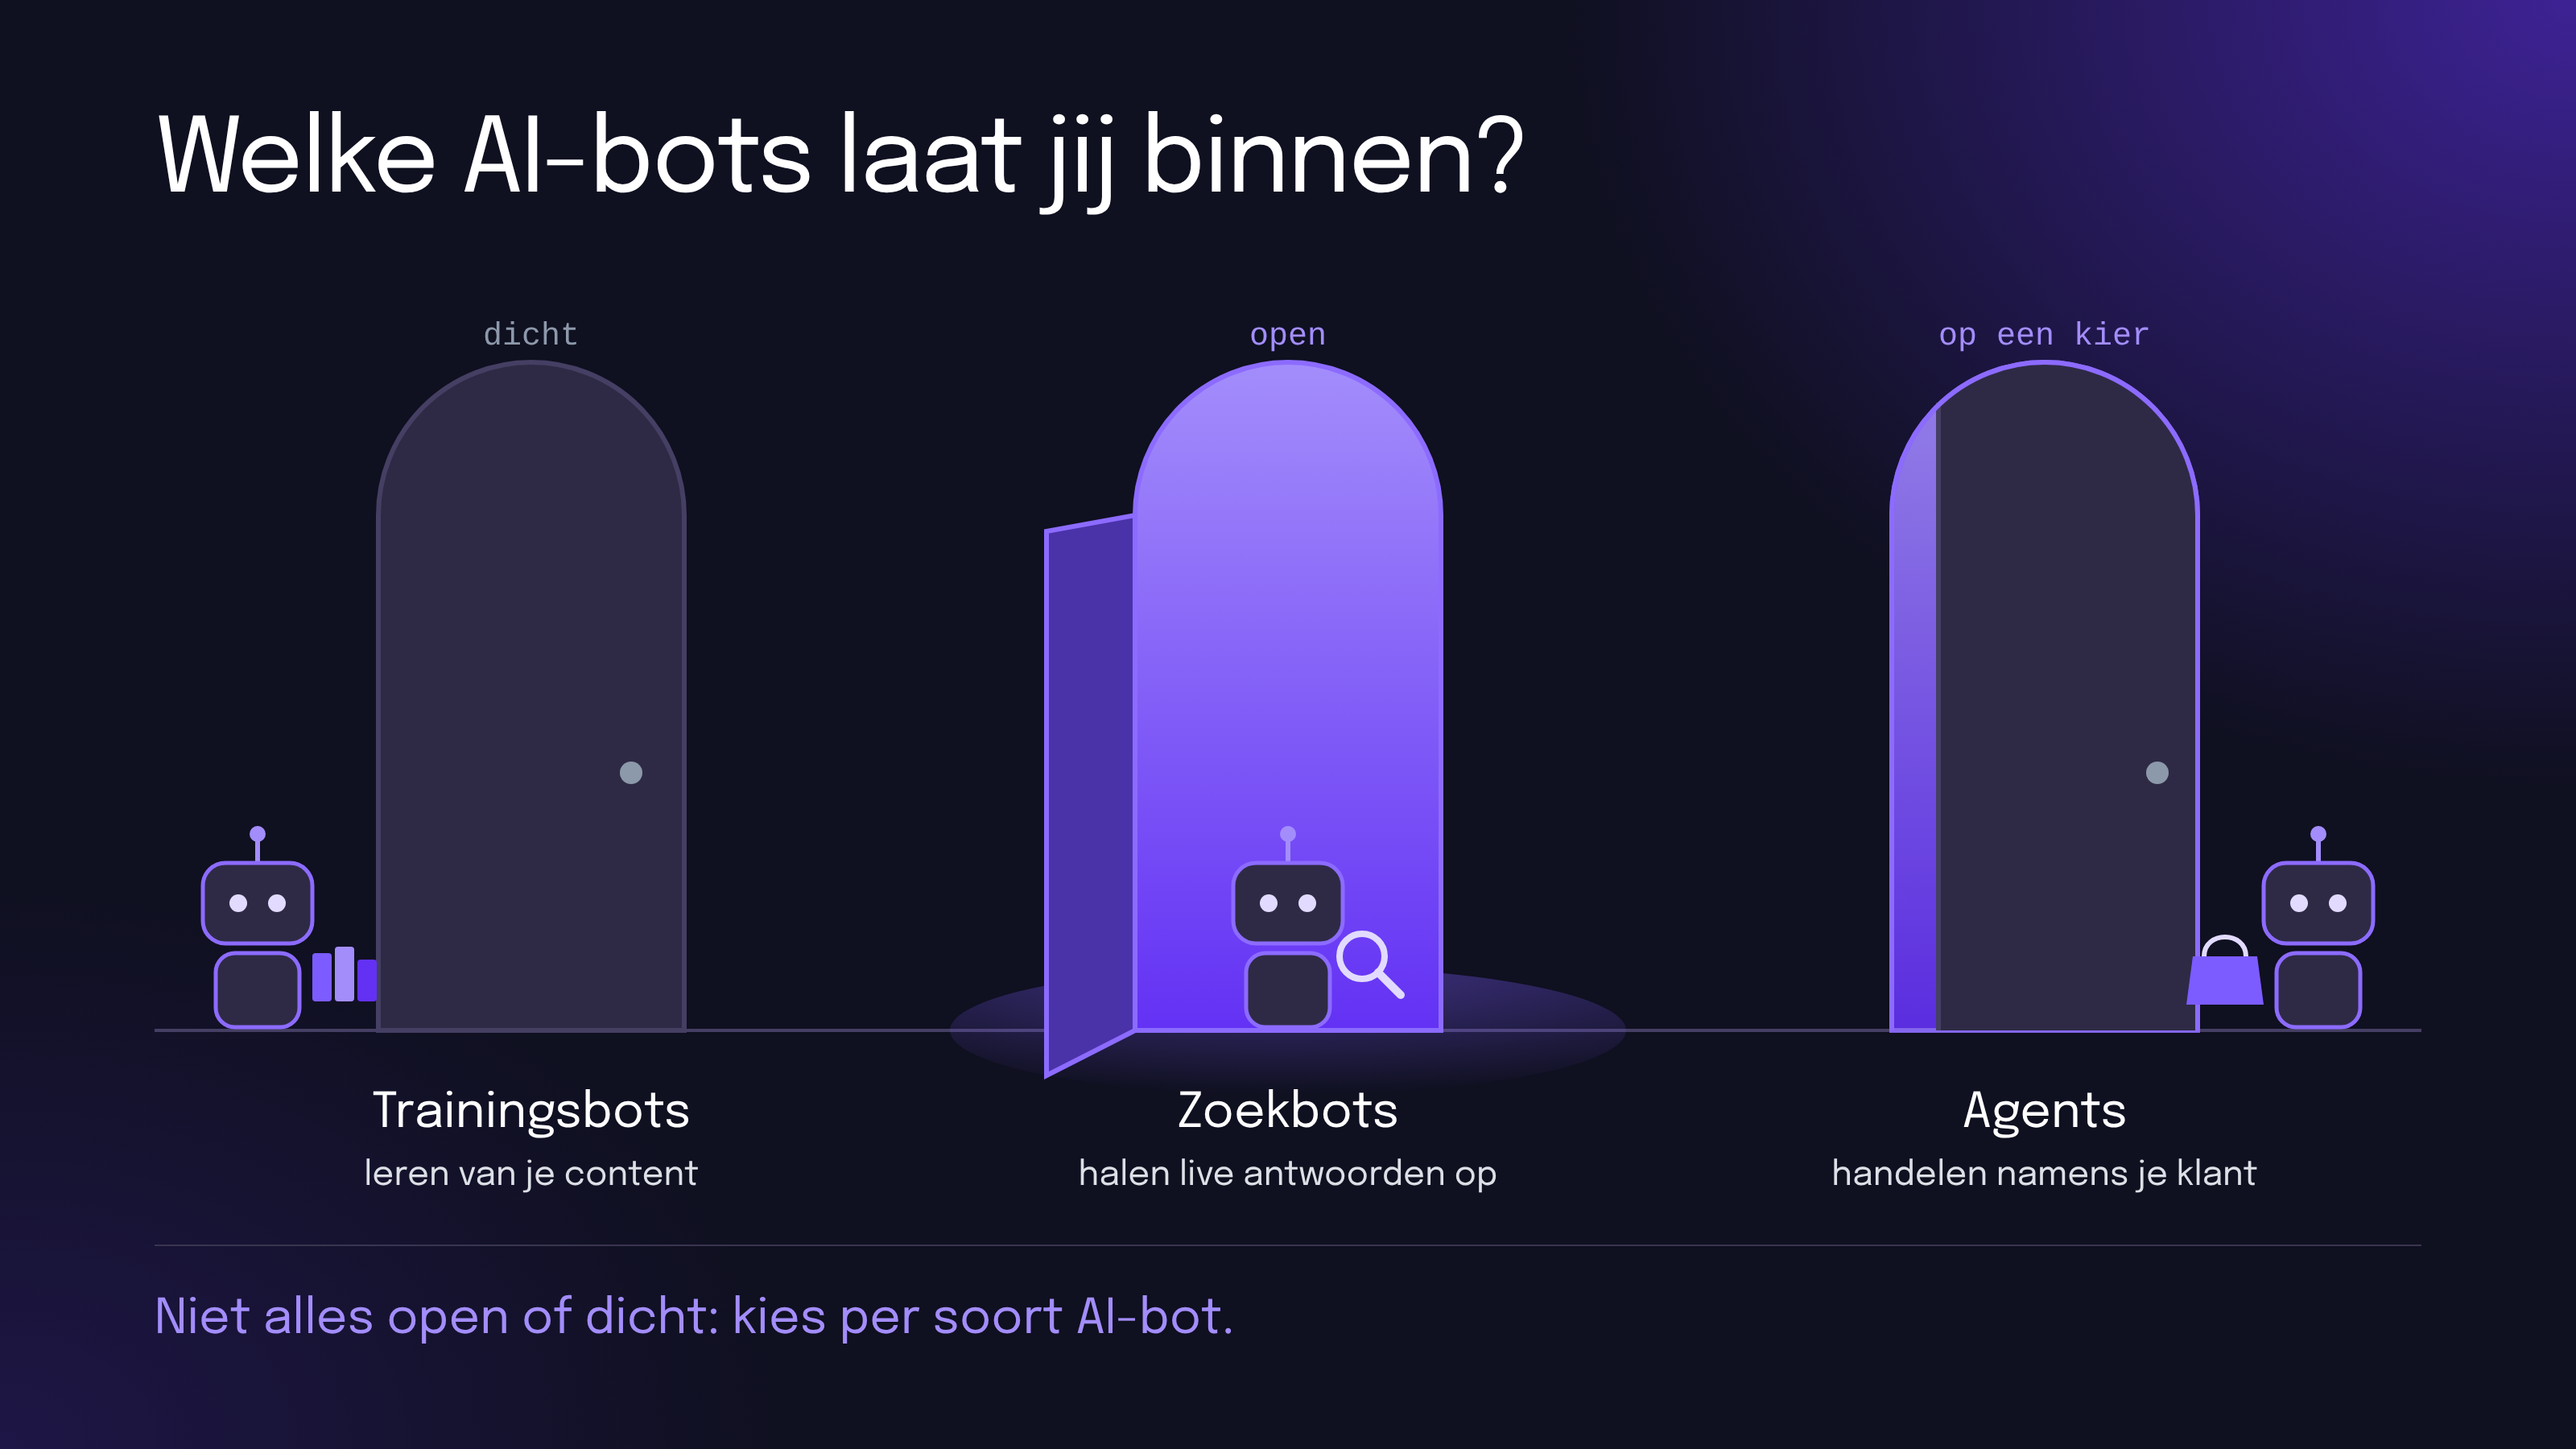
Voordeel: je merk wordt onderdeel van wat taalmodellen weten. Op de lange termijn vergroot dat de kans dat een model jouw merk koppelt aan je vakgebied.
Nadeel: je kennis wordt reproduceerbaar zonder dat iemand je site bezoekt of je noemt. En wat eenmaal getraind is, haal je er niet meer uit.
Voordeel: je kunt als bron verschijnen in actuele AI-antwoorden, vaak met een link naar je site. Dit is de meest directe route naar AI-vindbaarheid.
Nadeel: het antwoord vervangt soms de klik. De lezer krijgt je informatie, maar komt niet altijd bij je langs.
Voordeel: een klant kan via zijn AI-assistent direct bij je vergelijken, boeken of kopen. Je zit dan in de transactie, niet alleen in het advies.
Nadeel: je geeft het contact met je klant deels uit handen. De agent bepaalt hoe je aanbod wordt gepresenteerd, en je merkbeleving komt minder over.
Voor alle drie geldt bovendien: AI-bots kosten serverbelasting. Op grote sites kunnen ze dagelijks enorme aantallen verzoeken doen, wat druk legt op je server en je hostingkosten.
Drie dingen worden vaak vergeten als organisaties over AI-bots beslissen.
Ten eerste is een blokkade in robots.txt een verzoek, geen slot. Robots.txt is het bestand waarin je bots vertelt wat ze mogen lezen. Fatsoenlijke bots houden zich daaraan, maar niet elke bot doet dat. Echt gevoelige informatie hoort daarom achter een login.
Ten tweede haal je wat al getraind is er niet meer uit. Een blokkade werkt alleen voor de toekomst. Content die al in een model zit, blijft daar.
Ten derde is training weigeren iets anders dan onzichtbaar worden. Google, OpenAI, Microsoft en Anthropic steunen een gedeelde regel in robots.txt waarmee je AI-training kunt weigeren; Google wil die begin 2027 ondersteunen. Die regel gaat alleen over training. Voor live antwoorden en agents gelden aparte keuzes. Wie alles over één kam scheert, sluit de verkeerde deur.
Je bepaalt welke AI-bots je toelaat door te beginnen bij het doel van je website. Niet de techniek, maar je strategie bepaalt de keuze.
Is je website vooral een marketingmachine, gericht op vindbaarheid, leads en merkbekendheid? Dan wil je zoveel mogelijk openzetten, voor trainingsbots, zoekbots en agents. Elke blokkade kost je dan zichtbaarheid.
Staat er ook kennis op die je onderscheidt en die je niet met iedereen wilt delen? Dan maak je per onderdeel een keuze. Je kunt trainingsbots weren en zoekbots toelaten, zodat je wel als bron verschijnt in antwoorden. En wat echt vertrouwelijk is, zet je achter een login.
Leg die keuze vast als organisatie, niet alleen als technische instelling. Marketing, legal en IT kijken er elk anders naar. Een gedeeld standpunt voorkomt dat één afdeling de deur dichtgooit waar een andere afdeling juist zichtbaar wil zijn.
Je meet wat AI-bots met je site doen het best met je eigen data. Tools als Search Console, Microsoft Clarity en het dashboard van Cloudflare laten zien welke bots je site bezoeken en waar je als bron verschijnt. Data van derden, zoals rankingtools en prompttools, is waardevol om je met de markt te vergelijken, maar minder betrouwbaar geworden nu platformen meetbots actief tegenwerken. In ons artikel over de (on)mogelijkheden van AI-tracking lees je per tool wat je wel en niet meet.
Je maakt je website klaar voor AI-bots door het ze makkelijk te maken. Bots werken rechtlijnig: ze moeten snel snappen wie je bent, wat je doet en waar welke informatie staat. Een heldere structuur, duidelijke teksten en goede structured data helpen daarbij.
Dat is belangrijker dan ooit, omdat je op platformen weinig te zeggen hebt. Google en Reddit veranderen de regels wanneer het hen uitkomt. De enige plek waar jij de regels bepaalt, is je eigen website. Hoe je die geschikt maakt voor AI als gebruiker, lees je in ons artikel over agent experience (AX).
AI-bots worden belangrijker, en toegang tot data wordt duurder. Drie ontwikkelingen tekenen zich af.
De spelregels worden duidelijker. Met een gedeelde standaard voor AI-training krijgen websites meer grip op hoe hun content gebruikt wordt. Verwacht dat er meer van zulke afspraken komen, ook voor live antwoorden en agents.
Toegang wordt een handelswaar. Platformen met veel waardevolle content sluiten deals met AI-bedrijven en schermen zich af voor wie niet betaalt. Voor merken betekent dat: wat op zulke platformen staat, is niet voor elke AI meer zichtbaar.
En agents nemen het over. Steeds vaker bezoekt geen mens je site, maar een bot die namens iemand vergelijkt, selecteert en misschien zelfs koopt. Dan telt niet alleen of je gevonden wordt, maar ook of een agent je site begrijpt.
AI-bots lezen je website voordat je klant dat doet, en platformen schermen hun data steeds vaker af. Dat maakt toegang tot een strategische keuze: wat zet je open voor zichtbaarheid, en wat bescherm je omdat het je onderscheidt? Wie die keuze per soort AI-bot maakt, meet met eigen data en zijn website goed leesbaar maakt, staat sterker dan wie afwacht. Wil je samen bepalen welke AI-bots jij toelaat en hoe je je website klaarmaakt voor AI? Neem contact met ons op, dan denken we graag met je mee.